Hé, Gregor ici C'est une édition gratuite du bulletin d'information sur le leadership en génie. Chaque semaine, je partage 2 articles → Une édition payante et une édition gratuite, dans le but de faire de vous un grand leader en ingénierie ! Voici quelques-uns des récents articles populaires que vous avez peut-être manqués: Comment OpenAI optimise les agents d'IA pour l'échelleÀ l'intérieur du Harness, API, et des optimisations d'efficacité d'inférence qui soutiennent la croissance rapide de Codex et ChatGPT Work.
IntroductionAvec la croissance en flèche de Codex et ChatGPT Work à environ 10M utilisateurs, il ya un énorme besoin d'optimisations afin de soutenir ce type d'échelle. Comme vous le savez, construire l'infrastructure derrière des agents d'IA efficaces est beaucoup plus complexe que construire une infrastructure pour une interface de type chatbot. La raison en est que les agents d'IA peuvent prendre de nombreuses voies différentes pour accomplir une tâche, et comme les LLM ne sont pas déterministes, la même prompte peut produire des réponses différentes. Cela rend leur comportement beaucoup plus difficile à prédire, à déboguer et à tester. J'ai eu récemment le plaisir de parler à:
Ils m'ont fait part de nombreuses idées intéressantes sur l'appel, ainsi que par écrit. Et dans l'article d'aujourd'hui, je partage les principales améliorations de performance qu'OpenAI a récemment faites pour soutenir l'échelle et la croissance de leur base d'utilisateurs. Commençons ! Au-delà de choisir le bon modèle pour un emploi spécifiqueAvec la récente sortie de la série GPT‐5.6: Sol, Terra et Luna, chaque modèle est conçu pour un cas d'utilisation différent.
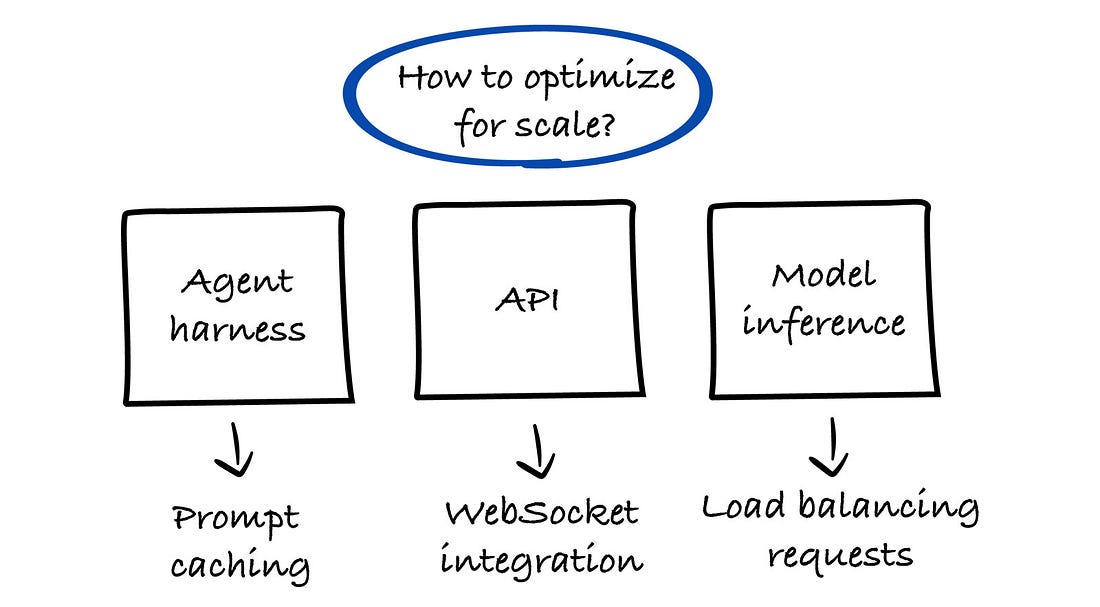
Ainsi, choisir le bon modèle seul peut certainement aider à la fois au niveau de l'infrastructure et pour les utilisateurs d'obtenir des réponses plus rapides qui pourraient coûter moins de jetons aussi. Mais dans cet article, nous allons au-delà de la sélection du modèle, nous allons dans les optimisations d'infrastructure réelles qui rendent les agents d'IA à la fois efficace et performant. Les 3 couches d'efficacité derrière les agents d'IA
Chaque fois que nous parlons de comment rendre les agents d'IA plus efficaces, les 3 couches principales que nous devons examiner sont:
C'est l'infrastructure qui dirige l'agent d'IA. Pensez au harnais comme la couche qui décide COMMENT un agent effectue une certaine action, tandis que le LLM décide ce qu'un agent doit faire. Sans le harnais, un agent d'IA ne peut répondre qu'aux questions, mais avec le harnais il peut rechercher le web, lire les fichiers, écrire et exécuter le code, appeler les API, récupérer des erreurs, etc.
L'API est la couche de communication entre l'Agent Harness et le LLM. Chaque fois que l'agent a besoin du modèle pour raisonner, planifier ou générer une réponse, il fait une demande d'API. Plus l'API peut envoyer des demandes et recevoir des réponses, plus l'agent entier devient rapide et moins cher. Pour accomplir une certaine tâche, un agent envoie généralement beaucoup de requêtes différentes, de sorte que même de petites améliorations dans l'efficacité de l'API peuvent avoir un impact énorme.
L'inférence est le processus de la LLM générant une réponse à partir de l'entrée qu'elle reçoit. C'est là que se produisent le raisonnement, la planification et la génération de texte. L'inférence est généralement la partie la plus coûteuse du calcul. Il fonctionne sur les GPU, et les GPU sont toujours un goulot d'étranglement, donc rendre cette partie plus efficace est crucial. Dans cet article, nous allons passer par les améliorations de performance faites dans chaque couche. Commençons par l'inférence. 1. Optimisations des inférencesComme mentionné, la puissance de calcul est toujours une contrainte, de sorte qu'il est crucial de pouvoir utiliser les GPU le plus efficacement possible. Les améliorations d'optimisation des performances apportées à l'inférence m'ont été communiquées par l'équipe OpenAI, mais leur interprétation est adaptée à cet article. Les plus récentes améliorations importantes de l'efficacité sur l'inférence que l'équipe d'OpenAI a récemment fait sont les suivantes.
L'équipe a fait savoir qu'elle répartissait le travail entre les instances modèles selon deux critères. La première est une distribution globale, basée sur la géographie, la capacité disponible, et aussi le type d'accélérateur (le type de GPU ou puce spécialisée exécutant le modèle). Le type d'accélérateur varie selon le modèle. Et le deuxième équilibrage de charge se produit dans le cluster des GPU, ils distribuent le travail à travers les instances de modèle en fonction de la charge, de la longueur du contexte, de la disponibilité du cache, et d'autres propriétés de requête. Ils ont vu des améliorations, en particulier avec l'utilisation de GPT-5.6 Sol dans Codex, ils peuvent mieux analyser le trafic et acheminer correctement les demandes à la bonne instance modèle.
Une passe avant est le processus d'obtention d'une sortie basée sur l'entrée spécifique. Le processus est le suivant : Calculs Prompt → model → probabilité pour le jeton suivant. Par exemple, si votre prompt est : -La capitale de la France est -. Lors d'une passe vers l'avant, le modèle traite le texte et calcule que Paris est probablement un jeton suivant. Chaque nouveau jeton nécessite habituellement un autre passe avant. Donc, une réponse de 100 jetons nécessite probablement 100 passes avant. Une chose intéressante que l'équipe a partagée avec moi est que avec Codex et leur dernier modèle (GPT-5.6 Sol), un agent AI a pu optimiser de manière autonome leurs noyaux de production, qui est le code de base qui exécute les opérations mathématiques du modèle. La raison pour laquelle le nouveau modèle a pu apporter des améliorations efficaces aux noyaux de production est parce qu'il a été formé sur Triton et Gluon, deux langages de programmation GPU open-source maintenus par OpenAI. Ils ont mentionné que ces optimisations réduisaient les coûts de service de bout en bout de 20%.
C'est un autre levier sur lequel ils ont travaillé, et c'est une technique où vous lancez un modèle plus petit à côté du modèle primaire. Le modèle plus petit propose plusieurs jetons pour le modèle primaire à vérifier en parallèle, et lorsque ces propositions sont acceptées, le système peut produire plusieurs jetons de sortie à partir d'une seule carte de modèle primaire. Cela réduit considérablement le calcul global nécessaire. Et de manière intéressante, comme les améliorations au noyau de production, ils ont utilisé leur dernier modèle (GPT-5.6 Sol) pour apporter des améliorations à la formation des spéculateurs de manière autonome. L'équipe a partagé que ces améliorations ont augmenté l'efficacité de la génération de jetons de plus de 15 %. Ils ont également mentionné que l'optimisation de l'inférence est une boucle de rétroaction continue, et il est important de mesurer le comportement de production et d'identifier les lacunes et de mettre en œuvre les changements nécessaires, tout en s'assurant qu'ils améliorent effectivement l'ensemble du système. 2. Optimisations de l'API
Dans notre conversation avec Steve Coffey, qui travaille sur l'API pour Codex et ChatGPT Work, il a mentionné que les 3 métriques de base qu'ils suivent dans leur API sont les suivantes:
Steve a également mentionné que la mesure la plus importante est la première (TTFT), elle donne un bon aperçu de la performance de leur API à la fois en recevant l'entrée, en faisant une certaine logique, puis en envoyant la demande au modèle AI et en recevant la réponse. À ce stade, je me demandais ce qu'ils préféraient, la vitesse globale de leur API ou sa disponibilité. Et Steve a mentionné que la disponibilité est la plus importante, et ils visent à 99,99 % de disponibilité sur leurs demandes. Le raisonnement est qu'il est beaucoup mieux que l'utilisateur obtient la sortie souhaitée (même si plus lentement) que pas du tout. Maintenant, laissez aller aux 3 améliorations de base qu'ils ont faites dans leur API afin de soutenir l'utilisation élevée. La première est certainement la plus grande. De l'API REST à l'intégration WebSocketIls ont vu l'une des plus grandes améliorations de performance en déplaçant beaucoup de la communication entre l'Agent AI communiquant via l'API REST vers WebSockets. La raison en est que lors de l'envoi d'une demande à une API REST, pour chaque demande, vous devez passer par la connexion initiale, qui peut ajouter jusqu'à un certain temps, en particulier avec un grand nombre de demandes envoyées. Ce que, bien sûr, comme nous l'avons mentionné, un agent d'IA envoie, même pour une tâche simple. Le grand avantage de l'utilisation d'une API WebSocket est que la poignée de main ne se produit qu'une seule fois (pour établir la connexion), puis les données sont envoyées sur cette connexion de manière beaucoup plus efficace. Steve a mentionné qu'ils supportent à la fois l'API REST et le WebSocket en même temps, comme certaines parties spécifiques passent encore par cette API, et aussi si la connexion réseau d'un utilisateur est très mauvaise, ils vont revenir à la communication de l'API REST. J'ai demandé à Steve si soutenir les deux est une partie problématique, mais il a mentionné que pas du tout. Il y a quelques nuances spécifiques aux deux parties, comme pour l'API WebSocket, ils doivent supporter de nombreuses connexions de longue durée, et s'ils font un autre déploiement, ils doivent s'assurer que les utilisateurs se reconnectent après. Le raisonnement pour ne pas être aussi problématique est que la logique fondamentale derrière les deux API est la même, juste la façon dont ces parties reçoivent et envoient les données est différente. Mais la logique fondamentale de la sécurité, de l'analyse et de la discussion avec les modèles d'IA est la même. Envoyer seulement de nouvelles choses à l'API, pas le contexte complet de la conversationPensez à la session complète du Codex et aux conversations de fond que vous avez. Avant l'optimisation, ils avaient l'habitude d'envoyer le contexte complet de la conversation dans chaque requête, ce qui, surtout dans les conversations plus larges, pouvait prendre beaucoup de temps à traiter. Avec l'intégration WebSocket, ils n'envoient maintenant que les données nouvelles, et ils gardent l'état du contexte sur le serveur. Le premier appel de la session commence le contexte, et il s'appuie sur chaque élément de données envoyé. Les données qui sont envoyées contiennent seulement ce qui est nouveau + la référence à la conversation, de sorte que le moteur sait où stocker ces données. Avec ce changement, ils ont vu environ 40% d'exécution de bout en bout plus rapide. Et imaginez que si vous avez une conversation très longue, j'imagine que la vitesse est beaucoup plus rapide qu'avant. Optimisation de l'efficacité du processeurToutes leurs infrastructures chez OpenAI sont déployées à l'aide de Kubernetes. Ce qu'ils ont découvert, c'est que les nœuds Kubernetes avec le même type d'instance ne possèdent pas toujours les mêmes processeurs CPU. Dans leur flotte, ils ont découvert que de nombreux nœuds utilisaient des processeurs désuets. Lorsqu'ils ont mesuré les ressources utilisées, ils ont constaté que les anciens processeurs utilisaient environ 2x autant de ressources CPU pour le même travail. Et passer aux nouveaux a amélioré le TTFT (Time to first token) de 20%. Ils ont repondu le trafic vers des processeurs plus efficaces et sont maintenant beaucoup plus diligents pour tester et optimiser les ressources du CPU. C'est un bon rappel, surtout si vous voulez optimiser les ressources du CPU, que vous testez et vérifiez continuellement les CPU périmés. Surtout si vous avez un service qui est en cours d'exécution depuis un certain temps, il est bon de vérifier si vous pouvez faire des optimisations, qui peuvent avoir beaucoup d'envers. 3. Optimisations du harnais des agents
Dans ma conversation avec Joe Gershenson, qui dirige l'équipe de l'Agent Core à OpenAI, et Ahmed Ibrahim, qui travaille sur l'Agent Harness, nous avons parlé des optimisations qu'ils ont faites sur le harnais. La première chose intéressante de notre conversation est ma question sur le genre de mesures sur leur tableau de bord de performance. Et intéressant, ils ont répondu que bien qu'ils aient des tableaux de bord spécifiques, comme Grafana ou similaire, la plupart de leurs tableaux de bord sont construits quand il ya un besoin pour elle. Comme mentionné dans un des récents articles sur la façon dont OpenAI construit des équipes d'infrastructure, l'un de leur projet, qu'ils ont construit est un Agent de données interne. Ils ont créé un outil interne où tout le monde à l'intérieur d'OpenAI peut poser des questions liées aux données et obtenir les informations nécessaires pour prendre des décisions fondées sur les données. Pas besoin d'aller aux ingénieurs de données pour générer un autre tableau de bord, ils peuvent simplement demander à l'agent de données d'obtenir les idées désirées qu'ils recherchent. Lire l'article complet : Donc, c'est ce qu'ils utilisent à l'intérieur de l'équipe de harnais pour suivre et obtenir des données liées aux performances. Et une chose cool que Ahmed et Joe ont mentionné est qu'ils peuvent partager le contexte d'un canal Slack ou d'un fil Slack, ou une capture d'écran spécifique d'une certaine demande, et l'agent de données va automatiquement chercher toutes les données nécessaires et créer les tableaux de bord corrects pour eux pour évaluer correctement ce qui se passe. Maintenant, laissez aller dans 2 améliorations de performance spécifiques qu'ils ont fait sur le harnais. Éviter le contexte inutileComme nous en avons déjà parlé dans la section API, ils utilisent l'intégration WebSocket pour juste ajouter les nouvelles données au contexte existant, qui est stocké sur le serveur. Au niveau du harnais, ils ont optimisé l'historique de la fenêtre de contexte avec l'approche appelée Découverte reportée. Cela rend les intégrations, les outils MCP personnalisés, les compétences, et toute sorte de choses supplémentaires seulement visible quand il est nécessaire. Dans le même temps, le harnais empêche également les outils individuels et les intégrations MCP de consommer de façon inattendue la fenêtre contextuelle. Ils ont également configuré une sortie de cap par défaut à 10k tokens, sauf si le modèle demande une limite différente. Cache rapideComme vous le savez, correctement la mise en cache joue un rôle important dans les optimisations de performance, dans ce cas, ils ont utilisé une technique appelée cache le préfixe rapide. Voici un bon exemple de la façon dont cela fonctionne. Imaginez cette invitation : Lorsque vous assignez une tâche à un agent d'IA, il la décompose en un certain nombre de tâches plus petites, mais il conserve le même ou le même préfixe rapide. Donc, tout avant la tâche actuelle : est le préfixe rapide. La seule chose qui change entre les requêtes est la tâche actuelle. Comme vous le savez, le traitement de longues invitations est coûteux. Donc, si le préfixe est identique sur de nombreuses requêtes, le harnais cache le préfixe et ne partage que le reste de ce dont il a vraiment besoin. Ce qui permet d'améliorer la rapidité et l'efficacité du fonctionnement d'un agent. Donc, c'est un excellent aperçu pour vous, en tant qu'utilisateur aussi. Si vous envoyez une invitation via API ou directement dans Codex, vous pouvez envoyer le préfixe comme partie de l'invite à tout moment, et il n'a pas contribué à une utilisation de jeton plus élevée en raison de la mise en cache du préfixe. Dernier motMerci tout particulièrement à Joe, Ahmed, Steve et au reste de l'équipe OpenAI pour avoir partagé avec moi toutes ces idées intéressantes. Beaucoup de ces idées n'ont pas été partagées publiquement auparavant, ce qui en fait la première fois qu'elles sont partagées dans ce niveau de détail. Il sera intéressant de voir comment l'infrastructure évolue alors que Codex et ChatGPT Work continuent de croître. Le dicton, "Qu'est-ce qui t'a amené ici ne t'a pas amené là," se sent particulièrement pertinent dans ce cas. Les optimisations qui prennent en charge les utilisateurs 10M ne seront probablement pas suffisantes pour 20M ou 30M. Comme les agents d'IA deviennent plus capables et obtiennent encore de meilleures capacités, chaque optimisation des performances sera encore plus importante. Vous avez aimé cet article ? Assurez-vous de cliquer sur le bouton comme. Rétroaction ou ajout? Assurez-vous de commenter. Tu connais quelqu'un qui trouverait ça utile ? Assurez-vous de partager ce post. Chaque fois que vous êtes prêts, voici comment je peux vous aider davantage
Contactez-nousVous pouvez me trouver sur LinkedIn, X, YouTube, Bleu ciel, Instagram ou Fils. Si vous souhaitez faire une demande sur un sujet particulier que vous souhaitez lire, vous pouvez m'envoyer un email à info@gregorojstersek.com. Ce bulletin est financé par des abonnements payants de lecteurs comme vous. Si vous n'êtes pas déjà, envisagez de devenir un abonné payant pour recevoir l'expérience complète! Vous êtes plus que les bienvenus pour trouver quels sont vos intérêts ici et l'essayer dans votre cas particulier. Faites-moi savoir comment ça s'est passé ! Les sujets portent normalement sur l'ingénierie, le leadership, la gestion, le développement de produits évolutifs, les équipes de construction, etc. Vous êtes actuellement un abonné gratuit à Leadership en génie. Pour toute l'expérience, Mettez à jour votre abonnement. |
 CORTEX